El cambio hacia la computación en el borde
Durante los últimos dos años, la estrategia predominante en la adopción corporativa de inteligencia artificial generativa se ha basado en el consumo de modelos masivos alojados en centros de datos remotos mediante llamadas a API. Si bien este esquema democratizó el acceso a capacidades cognitivas avanzadas, también introdujo cuellos de botella críticos: dependencia continua de conectividad de alta velocidad, costes recurrentes por volumen de tokens y preocupaciones estructurales sobre la soberanía y privacidad de la información procesada.
La presentación de Ministral 3B y Ministral 8B por parte de la francesa Mistral AI marca una inflexión técnica. Denominados colectivamente por el laboratorio como 'les Ministraux', estos modelos sub-10B han sido diseñados específicamente para resolver la tensión entre capacidad analítica y consumo energético, trasladando la ejecución del modelo directamente al hardware local: desde estaciones de trabajo y teléfonos móviles hasta controladores en planta industrial.
Arquitectura técnica y ventana de 128k tokens
El hito arquitectónico más relevante de esta familia radica en su capacidad para gestionar una ventana de contexto de 128.000 tokens en formatos de 3.000 y 8.000 millones de parámetros. Tradicionalmente, los modelos compactos se veían restringidos a ventanas de 4k u 8k tokens debido al crecimiento cuadrático del consumo de memoria en los mecanismos de atención, lo que impedía procesar documentos extensos o mantener historiales complejos en el borde.
Para superar esta restricción, Ministral 8B implementa un mecanismo de atención de ventana deslizante intercalada (interleaved sliding-window attention). Esta optimización reduce significativamente la huella de memoria durante la fase de generación del 'KV cache', acelerando la velocidad de respuesta y permitiendo que dispositivos con memoria unificada estándar procesen solicitudes extensas sin degradación térmica ni sobrecarga de memoria.
Comparativa de rendimiento en tareas analíticas
En las pruebas estándar del sector que miden razonamiento lógico, comprensión lectora y seguimiento de instrucciones complejas, la familia Ministral establece nuevas marcas de referencia en el segmento sub-10B. Ministral 8B supera consistentemente a alternativas directas como Gemma 2 9B y Llama 3.2 3B en benchmarks de conocimiento general y matemáticas, mientras que Ministral 3B ofrece una densidad de rendimiento por parámetro superior a la de competidores de mayor tamaño.
Este salto cualitativo resulta fundamental para las aplicaciones industriales donde los modelos no actúan simplemente como chatbots conversacionales, sino como motores de decisión autónomos capaces de validar esquemas de datos, resumir historiales operativos y coordinar herramientas locales sin intervención humana constante.
Distribución sectorial de la inferencia local
El despliegue de modelos compactos de alta fidelidad abre un abanico de casos de uso donde la nube tradicional resulta inviable o excesivamente costosa. En entornos industriales y de transporte, la latencia determinista es obligatoria: un sistema automatizado no puede tolerar los 400 milisegundos de latencia que introduce una ida y vuelta a un servidor central.
Asimismo, los sectores regulados como la banca privada, los servicios jurídicos y la administración pública encuentran en el paradigma on-device una respuesta directa a sus exigencias de confidencialidad, ya que los datos de clientes nunca abandonan el perímetro físico del equipo local.
- Distribución indicativa representativa basada en la viabilidad técnica actual de inferencia local.
Soberanía digital y cumplimiento del RGPD
Para el ecosistema empresarial europeo, la principal ventaja estratégica no es únicamente técnica, sino regulatoria. Bajo el marco del Reglamento General de Protección de Datos (RGPD) y las directrices emergentes del AI Act de la Unión Europea, el trasvase continuo de información sensible a infraestructuras en la nube extraeuropeas genera riesgos de cumplimiento y auditorías complejas.
Al albergar modelos como Ministral directamente en la infraestructura del cliente o en dispositivos corporativos distribuidos, el perímetro de seguridad se cierra. La información confidencial, los secretos comerciales y los datos médicos o financieros se procesan íntegramente en memoria volátil local, neutralizando vectores de fuga de información y reduciendo drásticamente la factura de servicios de computación en la nube pública.
Evaluación: viabilidad de Edge AI en su organización
Antes de acometer una migración de cargas de trabajo hacia arquitecturas locales de inferencia, las organizaciones deben analizar la madurez de su parque de hardware, los requerimientos de latencia y la naturaleza de sus datos de negocio.
El siguiente cuestionario diagnóstico permite valorar el grado de adecuación de su operativa para la adopción de modelos sub-10B en el dispositivo.
¿Cuál es la principal restricción operativa de sus aplicaciones actuales de IA?
Repercusión en el tejido empresarial de Barcelona y Catalunya
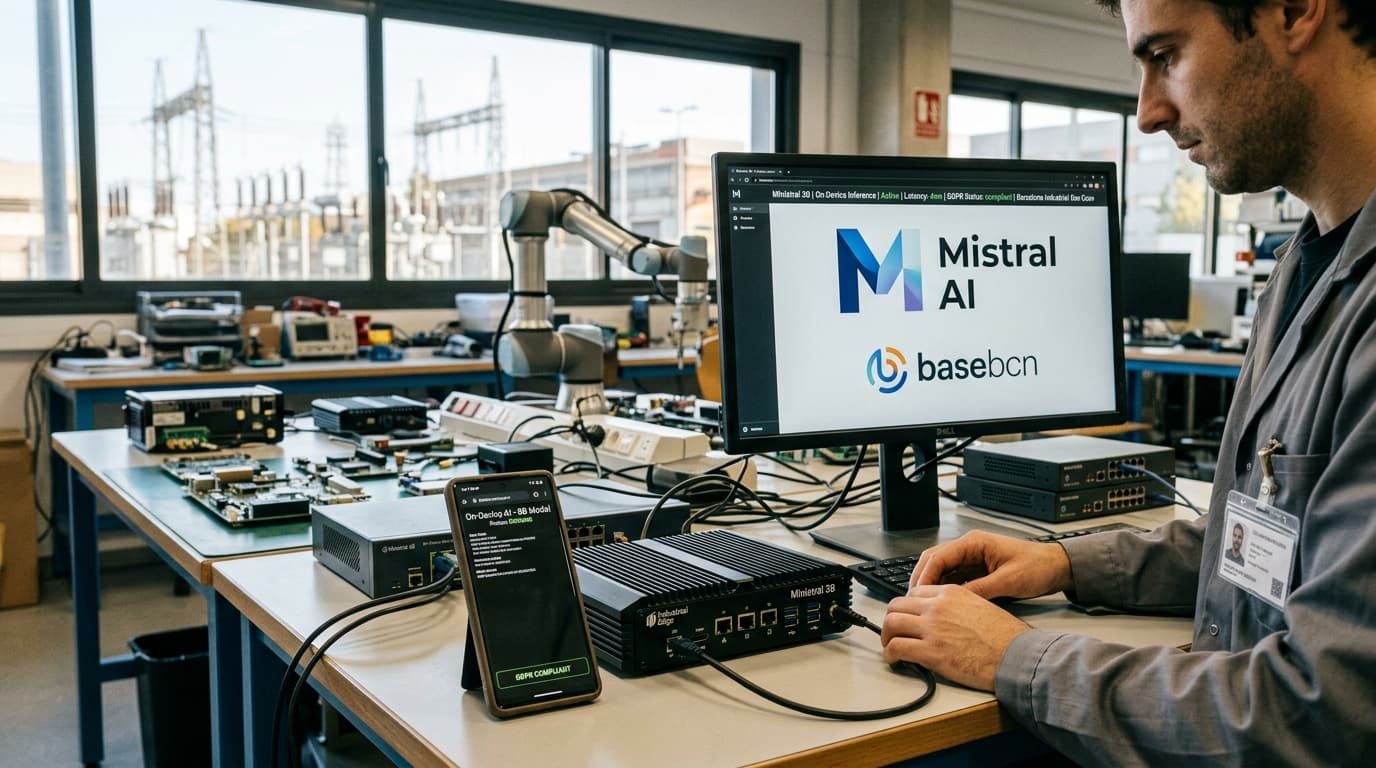
El lanzamiento de Ministral cobra especial relevancia para el polo tecnológico de Barcelona y el cinturón industrial de Catalunya. Empresas de los sectores químico, farmacéutico, manufactura avanzada y automoción llevan meses buscando alternativas viables a las soluciones de nube propietarias, limitadas a menudo por políticas corporativas de confidencialidad de datos.
Asimismo, el ecosistema de startups tecnológicas locales que desarrollan aplicaciones móviles y soluciones de salud digital puede ahora integrar capacidades conversacionales y analíticas complejas directamente en sus aplicaciones cliente, evitando que el coste unitario por consulta penalice su modelo de negocio al escalar.
Perspectivas de la computación autónoma
La evolución hacia sistemas locales no implica la desaparición de los grandes modelos de lenguaje en centros de datos, sino la consolidación de un esquema colaborativo multinivel. En este paradigma, modelos ultrarrápidos y ligeros como Ministral actúan como agentes de primera línea que resuelven peticiones en milisegundos, filtran información confidencial y delegan únicamente problemas de razonamiento extremo a modelos superiores.
Con esta propuesta, Mistral AI refuerza la competitividad europea en el ecosistema global de IA, demostrando que la eficiencia algorítmica y la optimización de recursos computacionales son tan determinantes para el éxito empresarial como la escala masiva de parámetros.
“La transición hacia modelos sub-10B redefine el equilibrio entre rendimiento computacional, privacidad regulatoria y coste de infraestructura en el sector corporativo.”